研究紹介

ゲーム一般

ゲーム一般

ゲームAIの思考方法や学習方法は,ゲームの性質たとえば完全情報/不完全情報,人数(1,2,3以上),報酬(ゼロ和/その他)などで,適する手法や難しさが大きく変わります.適した性質を持つゲームを題材とすることで,様々な則面から手法を評価することができます. 二人ゼロ和完全情報ゲームについては,囲碁や将棋のページもご覧ください.

Catan

JSettlers bot x 3 との4人ゲームで, 勝率50%超 を達成しています.

強化学習

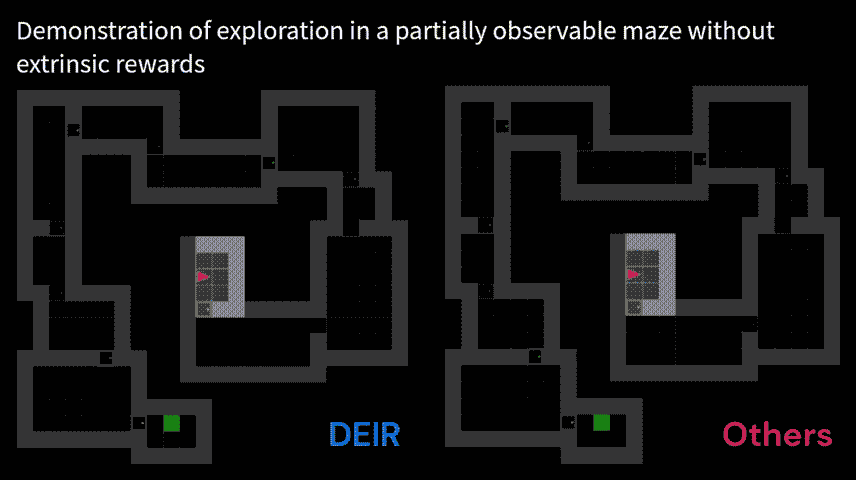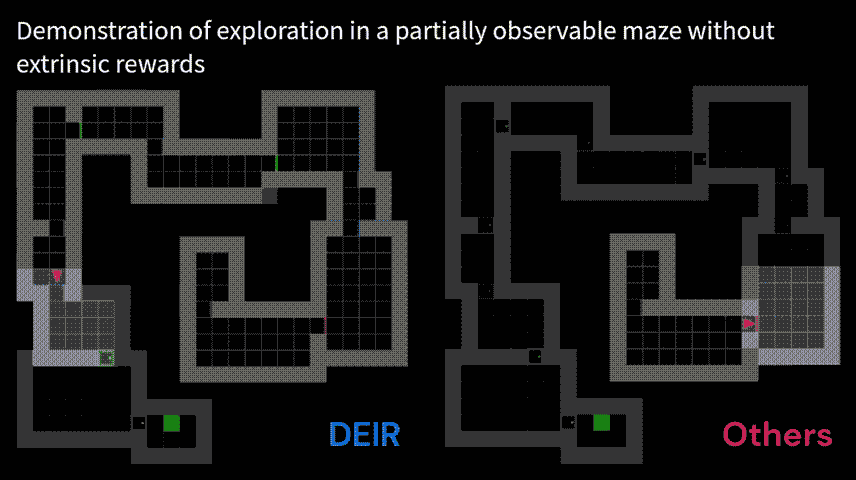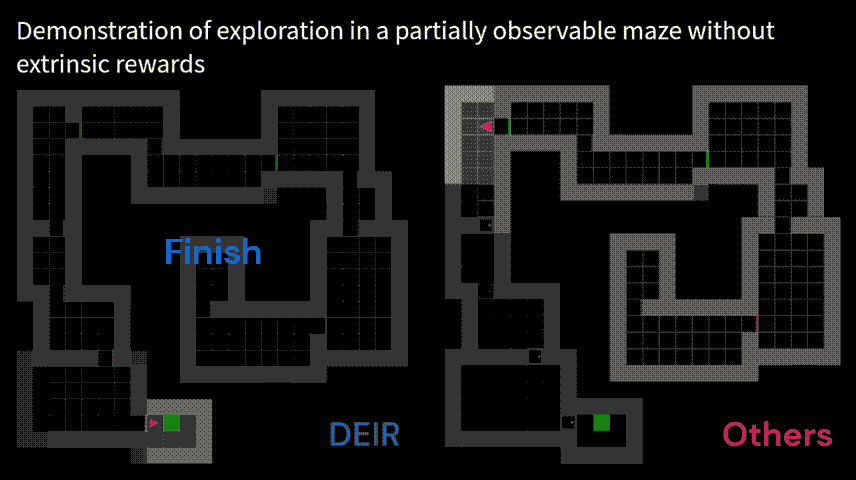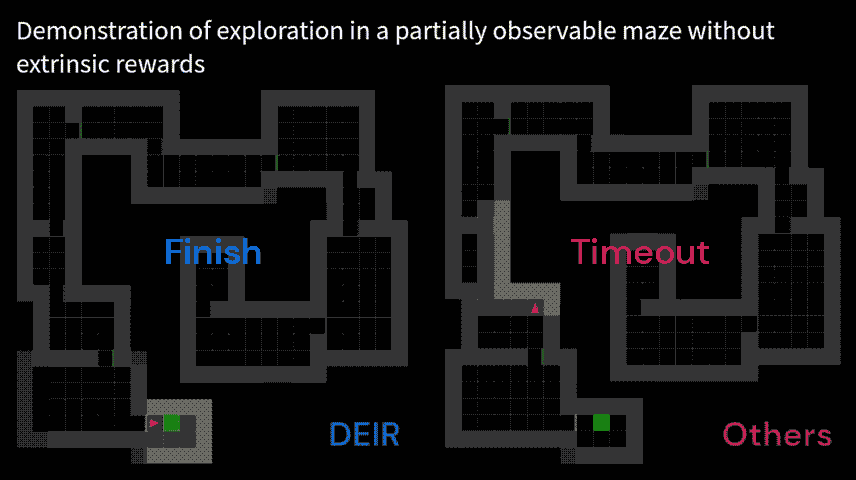
ゲームにおける強化学習を研究しています. 対象ゲームに関する人の知識や棋譜などを使わずに,ゲームのルール,あるいはシミュレータを通しての経験だけから学ぶことに挑戦があります.AlphaZeroも強化学習の応用と位置づけられます.

将棋

将棋

コンピュータ将棋の研究を行っています。

学習

  • Demura, Y. and Kaneko, T. “Initial state diversification for efficient alphazero-style training,” ICGA Journal, 46(2) pp. 40-66. 2024, doi: 10.3233/ICG-240255.
    • 将棋81万 (shogi816k): 約81万通りの初期局面集で,将棋の強化学習を加速します

サッカー

サッカー

HFO (Half Field Offense) での強化学習

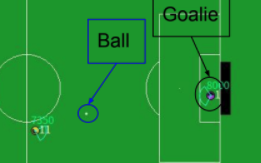
Half field offense RoboCup 2D Soccer (HFO) は RoboCup のシミュレーション環境の課題の一つで,強化学習の課題の一つです. 行動空間の階層性を適切に扱うため(turn 30 のようにパラメータ付き行動を扱うため),HA-PPOを提案しました.1:1での得点成功率約71%と強化学習手法では過去最高の成績を実現しました.
探索

探索

並列・分散探索

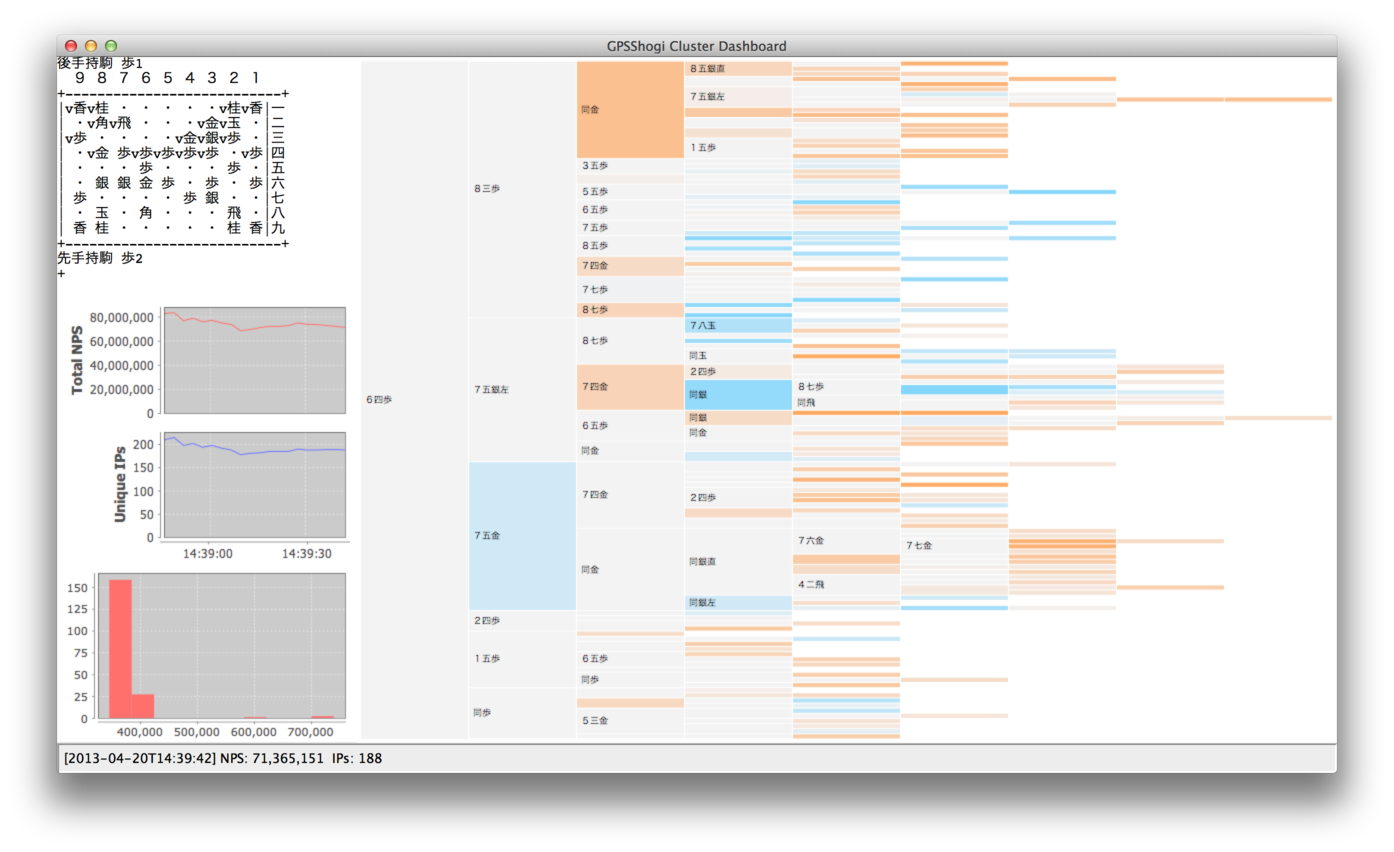
多数の計算機で協調して、効率よく探索する方法を研究しています。